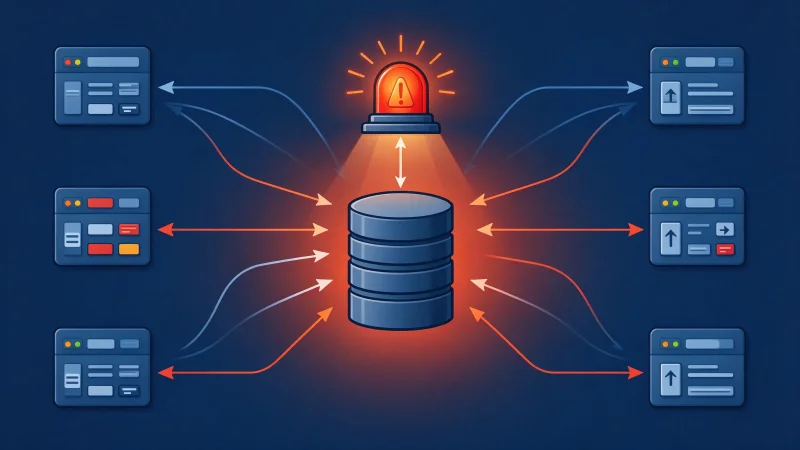
周一下午,正在写新功能,运营群里突然炸了锅:"后台打不开了!""页面一直转圈!""我的订单没反应!"
我赶紧打开监控面板,一眼就看到了异常:数据库连接池的使用率100%,所有请求都在排队等待连接。
这是一次典型的连接池耗尽事故。从爆发到恢复,花了将近一个小时。记录一下整个过程,希望以后不再踩同样的坑。
事故现象
刚开始只是后台某些页面变慢,大家以为又是网络波动。但不到五分钟,前台也开始卡了,用户反馈页面加载不出来,下不了单。
看监控数据:
- 数据库连接数:飙到上限,100%占用
- 活跃连接:大部分被阻塞,在等待获取连接
- 应用日志:大量"连接池已满,等待超时"的错误
- 数据库本身:CPU正常,慢查询不多
也就是说,数据库本身没问题,是应用层把连接都占住了,新的请求拿不到连接。
排查过程
第一步,先看是哪些请求占用了连接。
用数据库的processlist查了一下,发现大量的连接都卡在一条SQL上:
SELECT * FROM orders WHERE user_id = ? ORDER BY id DESC LIMIT 10这条SQL按理说很简单,有索引,不该慢。但它在processlist里占了将近一半的连接,全部处于"Waiting for table metadata lock"状态。
元数据锁(metadata lock)!问题找到了方向。
元数据锁是什么?简单说,MySQL在执行DDL(比如ALTER TABLE)时,会获取表级元数据锁。在这个锁释放之前,所有访问这张表的查询都会被阻塞。
而我的连接池里的连接,一旦有请求被阻塞,连接就被占着不放。阻塞的请求越来越多,连接池很快就被占满了,其他正常的请求也拿不到连接。
根因:一条没跑完的DDL
查了一圈,终于找到了罪魁祸首:上午有个同事(对,就是运营要加个字段)在orders表上执行了一个ALTER TABLE,加一个字段。
按理说,加字段很快,几秒钟就完事。但问题是,当时正好有一个长事务开着,一直没有提交。ALTER TABLE在等这个事务结束,获取元数据锁。
而那个长事务,因为某个业务逻辑卡住了,一直没提交。DDL等锁,查询被DDL阻塞,连接池被占满,雪崩就来了。
紧急恢复
定位到根因后,处理就比较直接了:
第一步:杀掉阻塞DDL的长事务
找到那个长事务的连接ID,KILL掉。DDL马上拿到了元数据锁,执行完成,释放锁。被阻塞的查询立刻恢复。
第二步:重启应用(连接池重建)
虽然锁释放了,但连接池里还有大量积压的请求和异常状态。重启应用,让连接池重新初始化,清掉所有卡住的连接。
第三步:观察恢复情况
重启后,连接池使用率从100%逐步降下来,页面恢复响应,订单可以正常提交。整个恢复过程大概15分钟。
为什么会出现这种情况
事后复盘,这次事故有三个层面的问题:
1. 长事务
那条业务逻辑为什么会卡住?查了代码,发现是一个老功能,里面有个循环查库的操作,数据量大了以后非常慢,事务开着一直不提交。这是直接的诱因。
2. 无锁迁移(大表DDL)
在MySQL 8.0里,ALTER TABLE默认会用INSTANT算法或者INPLACE算法,但依然需要短暂的元数据锁。如果表很大或者有长事务,这个锁等待就会很久。
对大表加字段,应该用gh-ost或pt-online-schema-change这类在线变更工具,或者在低峰期执行。
3. 连接池没有熔断
连接池满了以后,新的请求应该快速失败(比如返回503),而不是无限等待。我们没有配置"获取连接超时",导致所有请求都堆在连接池上,越积越多。
改进措施
针对这三个问题,我们做了以下改进:
1. 长事务监控
新增了一个监控脚本,每分钟检查一次数据库,发现超过60秒未提交的事务就告警。同时写了一个自动清理脚本,对超过10分钟的事务自动KILL(只针对特定的业务账号)。
2. DDL规范化
制定了一个规则:所有生产环境的大表DDL,必须:
- 先在测试环境跑一遍,评估耗时
- 用在线DDL工具(gh-ost)执行
- 安排在凌晨低峰期执行
- 执行前检查是否有长事务
3. 连接池配置优化
调整了连接池参数:
- 设置获取连接超时时间(比如3秒)
- 设置最大等待队列长度,超出的请求直接拒绝
- 增加连接池健康检查,自动剔除坏连接
4. 快速降级
加了一个简单的熔断机制:当连接池使用率超过80%时,非核心接口直接返回缓存数据或降级响应,优先保障下单、支付等核心流程。
经验总结
这次事故给我几个深刻的教训:
1. 数据库操作要敬畏
一条简单的ALTER TABLE,在特定条件下能拖垮整个系统。对大表的任何结构变更,都要当成一次"手术"来对待,评估风险、做好准备、安排时间。
2. 连接池不是无限的
连接池是有限资源,一定要设置超时和熔断。宁可让一部分请求快速失败,也不要让所有请求堆在一起雪崩。
3. 长事务是定时炸弹
长事务的危害平时看不出来,但一旦遇到DDL,就会引发连锁反应。一定要有长事务的监控和告警机制。
4. 监控告警要及时
如果告警能更早触发,我们能在5分钟内定位问题,而不是等到全站卡死才发现。连接池使用率、活跃连接数、阻塞查询数,这些指标都应该有告警。
写在最后
恢复之后,我在团队群里发了一条消息,说明了事故原因和处理过程。然后整理了一份《生产环境数据库操作规范》,发给了所有人。
晚上下班的时候,看到那个引发问题的同事还坐在工位上。我走过去说:"没事,复盘完了,下次注意就行。"他松了口气,说:"下次做任何数据库操作,我一定先报备。"
线上事故不可怕,可怕的是同样的坑踩两次。把每一次事故都变成一次学习,系统就会越来越健壮。
毕竟,程序员的成长,就是在一次次的故障中,学会敬畏。
评论(0)
暂无评论,快来抢沙发~
评论功能仅对会员开放,请先登录
登录